
Robots.txt para IA: decide si entrenan con tu web
Google prevé respetar en 2027 una señal común en robots.txt para decir si tu web sirve para entrenar IA. Qué cambia y cómo decidir qué abrir y qué no.
Blog · · 6 min · Equipo digizone
El robots.txt para IA está a punto de simplificarse: Google ha anunciado que, junto con otros proveedores de inteligencia artificial, quiere respetar en 2027 una señal común con la que cualquier web puede decir, en una sola regla, si acepta que su contenido se use para entrenar modelos. Para una empresa con web propia, la pregunta deja de ser técnica y pasa a ser de negocio: qué parte de tu web quieres que aprendan los modelos y qué parte no.
En pocas palabras
- Google anunció el 30 de octubre de 2026 que quiere respetar en 2027, junto con otros proveedores de IA, una señal común en robots.txt con la que una web dice si acepta que se entrene IA con su contenido.
- La señal se llama __usage_ai-training y sale de un borrador individual presentado en el IETF por Kevin Kelley, de Anthropic: es una preferencia, no una obligación, y todavía no es un estándar.
- Según Google, frenar el entrenamiento con Google-Extended no saca a una web de su buscador, pero sí puede dejarla fuera de las respuestas con enlace de la app Gemini.
- Lo útil hoy es separar qué parte de tu web es escaparate y cuál es producto, decidir para cada una y cerrar con acceso privado lo que no quieras compartir.
Qué cambia con el robots.txt para IA
El 30 de octubre, Google explicó en su blog para propietarios de webs que piensa admitir un control compartido de entrenamiento de IA en el robots.txt, el fichero de texto que cada web tiene en su raíz para dar indicaciones a los robots que la recorren. La propuesta se basa en el trabajo del grupo AIPREF del IETF, el organismo que define buena parte de los estándares de internet. Google dice que su objetivo es admitirla junto con otros proveedores de IA en 2027, y en su documentación de rastreadores concreta que será a principios de 2027.
Hoy, quien quiere frenar el entrenamiento tiene que escribir una regla para cada empresa, como recuerda heise: GPTBot para OpenAI, ClaudeBot para Anthropic o Google-Extended para Google, entre otros. La señal común usa un solo nombre, __usage_ai-training, definido en un borrador presentado ese mismo día en el IETF por Kevin Kelley, de Anthropic. No inventa sintaxis nueva: se escribe como cualquier otra regla del robots.txt y permite, por ejemplo, decir que no al entrenamiento en toda la web salvo en la sala de prensa.
Hay tres matices. El borrador es una propuesta individual que, según su propio texto, aún no tiene rango formal en el IETF. Tampoco obliga a nadie: expresa una preferencia, y el mismo borrador admite que un acuerdo privado puede pasar por encima de ella. Y no sustituye a las reglas de cada empresa: según Google, seguirán funcionando, y podrás marcar una decisión general y afinarla para un proveedor concreto.
Recetas gratis, cursos de pago y una duda
Imagina que Teresa dirige una escuela de cocina con dos cocineros. En su web cuelga cada semana una receta gratis, con fotos que hace ella misma con el móvil, y vende cursos en vídeo en una zona para alumnos. Las recetas atraen visitas; los cursos pagan las facturas.
Un martes, una alumna le cuenta que un asistente de IA le ha dado una receta de arroz que se parece mucho a la suya. Teresa no sabe si es casualidad. Su sobrino le dice que lo bloquee todo y se olvide. Pero ella también quiere que, cuando alguien pregunte a un asistente por un curso de cocina en su ciudad, aparezca su escuela. Y no sabe si una cosa impide la otra.
¿Por qué casi nadie ha decidido qué hace la IA con su web?
A muchos negocios les pasa lo mismo que a Teresa. La web la montó alguien hace años, nadie ha abierto nunca el robots.txt y las decisiones sobre la IA se han tomado por omisión. Hasta ahora, además, decidir era incómodo: había que seguir la lista de robots de cada empresa y escribir una regla para cada uno.
Y se mezclan tres cosas distintas: que tu web salga en Google, que un asistente use tu página como fuente para responder con un enlace, y que tus textos y fotos sirvan para entrenar un modelo. Cada una se gobierna con reglas propias, y confundirlas lleva a decisiones que nadie quería tomar.
¿Qué te juegas si no decides?
Si no dices nada, el uso de tu contenido lo deciden otros. Para un negocio cuyo producto es justo ese contenido, como recetas, cursos, guías o fotos, es mucho dejar al azar.
El error contrario también cuesta. La documentación de Google dice que Google-Extended no afecta a la inclusión de una web en su buscador ni se usa para clasificarla, así que frenar el entrenamiento no te saca de Google. Pero en su anuncio Google añade que las webs que permiten expresamente Google-Extended pueden salir con enlace en las respuestas de la app Gemini, y que usar la señal común para decir que no al entrenamiento, sin una regla propia para Google-Extended, contará como si lo hubieras bloqueado. Cerrarlo todo sin pensar puede dejarte fuera de esas respuestas.
Y una advertencia: el robots.txt funciona por buena fe. Como recuerda heise, no sustituye a una restricción técnica de acceso, y solo lo respetan los proveedores que deciden hacerlo.
¿Cómo preparar tu web antes de 2027?
No hace falta esperar a que la señal común funcione para ordenar la decisión. Estos pasos sirven ya:
- Haz inventario de tu contenido y sepáralo en dos montones: lo que es escaparate (servicios, precios, contacto, prensa) y lo que es producto (cursos, guías descargables, fotos de pago).
- Decide para cada parte si aceptas que se use para entrenar modelos y si quieres aparecer como fuente en los asistentes. Son dos preguntas separadas.
- Abre tu robots.txt actual en tudominio.com/robots.txt y comprueba qué robots menciona y qué les permite.
- Pon lo que de verdad es de pago detrás de un acceso con usuario y contraseña: el robots.txt es una petición, no una cerradura.
- Anota en el calendario una revisión para cuando Google y los demás proveedores confirmen que ya leen la señal común, porque la propuesta sigue en debate.
Para Teresa, el resultado podría ser este: la página de cursos y la de contacto, abiertas a todo; las recetas gratis, con su decisión sobre el entrenamiento por escrito; la zona de alumnos, tras su contraseña, como ya está. Tres decisiones, cada una con su motivo.
Lo que hacemos en digizone con el contenido de tu web
En digizone ayudamos a las empresas a tomar decisiones tecnológicas con criterio desde nuestra consultoría tecnológica: revisamos qué publica tu web, qué indicaciones da a buscadores y asistentes, y lo alineamos con lo que quieres proteger y lo que quieres mostrar.
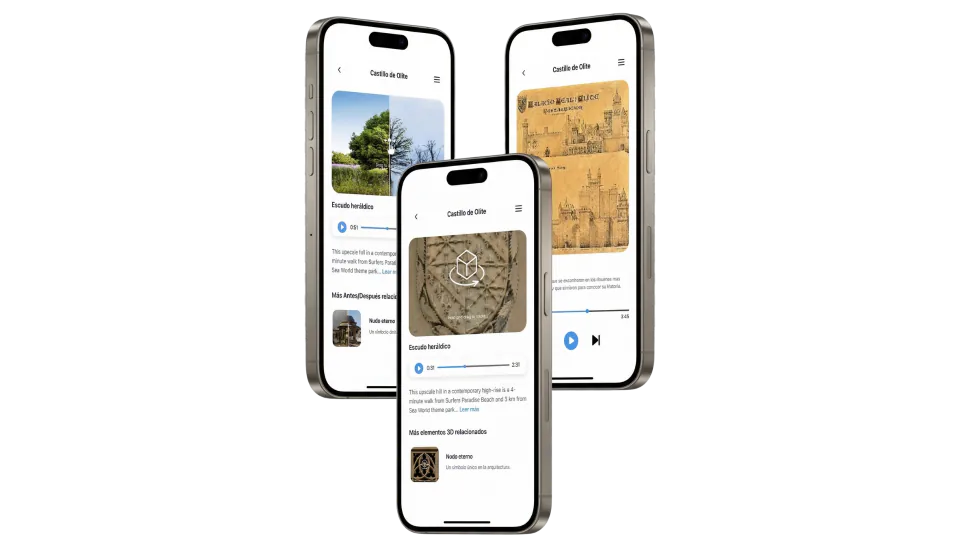
Lo vemos a menudo en proyectos donde el contenido es el corazón del negocio. En CulturApp desarrollamos una web app que convierte lugares de interés en recorridos con textos, imágenes, audios, vídeos e incluso elementos en 3D, con un panel desde el que gestores y colaboradores crean sus propios contenidos. Gestionar accesos gratuitos o de pago formaba parte del reto desde el principio, y separar lo abierto de lo reservado es la misma pregunta que ahora toca hacerse con la IA.
Empieza por tres filas
No necesitas una política de IA de veinte páginas. En la escuela de Teresa, la primera versión sería una tabla de tres filas, recetas, cursos y zona de alumnos, con lo que permite y lo que no al lado de cada una. Con eso, quien cuida su web puede escribir hoy las reglas por proveedor y dejar pensada la regla común para cuando llegue. Si mañana añade un recetario descargable, suma una fila.
Si quieres ver cómo se haría en tu caso, en nuestro taller gratuito lo contamos paso a paso.
Preguntas frecuentes
¿Qué es el robots.txt y dónde está?
Es un fichero de texto que vive en la raíz de una web, en la dirección tudominio.com/robots.txt, y da indicaciones a los robots que la recorren: buscadores, rastreadores de empresas de IA y otros. Cada bloque dice a qué robot se dirige y qué carpetas puede o no visitar. Lo puedes abrir desde cualquier navegador; para cambiarlo hace falta acceso al servidor o al gestor de la web.
¿Si bloqueo el entrenamiento de IA, desaparezco de Google?
No por eso. Según la documentación de Google, Google-Extended, la regla con la que se frena el entrenamiento de sus modelos Gemini, no afecta a la inclusión de una web en Google Search ni se usa para clasificarla. Google sí explica que las webs que lo permiten expresamente pueden salir con enlace en las respuestas de la app Gemini, así que bloquearlo puede dejarte fuera de ellas.
¿Cuándo empezará a funcionar la señal común de entrenamiento de IA?
Google dice que quiere admitirla junto con otros proveedores de IA en 2027, y su documentación habla de principios de 2027. La señal sale de un borrador individual presentado en el IETF el 30 de octubre de 2026, que aún no es un estándar. Mientras tanto, siguen sirviendo las reglas de cada proveedor, como GPTBot, ClaudeBot o Google-Extended, entre otras.
¿El robots.txt impide de verdad que usen mi contenido?
No es una cerradura. Expresa una preferencia que respetan los proveedores que deciden hacerlo, y el borrador de la señal común admite que un acuerdo privado puede pasar por encima de ella. Lo que de verdad sea de pago o confidencial debe estar detrás de un acceso con usuario y contraseña, que es una restricción técnica y no depende de la buena fe de nadie.
¿Me conviene bloquear el entrenamiento de IA en toda la web?
Depende de qué publiques. Lo razonable es separar el escaparate (servicios, precios, contacto, prensa), que te interesa que circule, del producto (cursos, guías, fotos de pago), que es lo que vendes. La señal común permite decir que no en general y abrir carpetas concretas, o al revés, así que la decisión puede hacerse por partes y no a todo o nada.
Fuentes
Sobre digizone
digizone es una empresa de desarrollo de software a medida fundada en 2019, con oficinas en Barcelona y Cartagena. Diseñamos y desarrollamos apps móviles, aplicaciones web, CRM/ERP y automatización con IA para startups, pymes y grandes empresas. Conoce al equipo
Otros artículos
No te quedes atrás: si quieres estar al día acerca del siempre agitado y veloz sector tecnológico, echa un vistazo a los siguientes artículos:
Formación en IA para empleados: lo que frena a las pymes
Según el Banco de España, la falta de personal cualificado es el mayor freno a la IA y pocas pymes prevén formar a su equipo. Cómo empezar con quien ya tienes.
Leer más »
Vulnerabilidad de PHP: qué revisar si tu web usa WordPress
PHP ha corregido dos fallos críticos, hallados con ayuda de la IA, que dejan tomar el control de una web. Qué preguntar hoy a tu hosting si tu empresa usa WordPress.
Leer más »
Agentes de compra con IA: tu tienda también tiene que leerse
Walmart abre su tienda a los agentes de compra con IA, que buscan y compran por el cliente. Qué supone para una tienda online pequeña y qué revisar en tu web.
Leer más »Contacta con nosotros
¿Tienes alguna pregunta? ¿Quieres que acordemos una llamada o una cita? Estaremos encantados de solventar cualquier duda y comenzar a trabajar contigo. La solución digital idónea para tu negocio está muy cerca.
Suscríbete a la newsletter
¡Descubre el futuro digital suscribiéndote a nuestra newsletter exclusiva! Mantente al tanto de las últimas tendencias y novedades del mundo tecnológico. ¡No te pierdas la oportunidad de ser el primero en conocer las innovaciones que están transformando el presente! Suscríbete ahora.